[Nyummy] 식사 기록 및 영양 분석 Write-Behind 구현기
나는 Nyummy에서 영양 분석 파이프라인을 담당하고 있다.
식사 사진을 올리면 AI가 영양을 분석해 주는데, 분석에 10초 가까이 걸린다. 그래서 기록은 바로 받고 분석은 뒤에서 처리하도록, RDB 기반 Task Queue로 비동기 작업을 설계하고 구현했다.
구현을 마치고 나니 이 구조가 피크에 어디까지 버티는지 확인하고 싶었다. 식사 기록이 한꺼번에 몰리도록 부하를 걸어 보니, 가장 먼저 한계에 닿은 것은 API도 Worker도 아닌 RDS였다.
그래서 분석 결과를 MySQL에 바로 쓰지 않고, Redis에 먼저 쌓아 두었다가 나중에 옮기는 Write-Behind를 붙였다. 쓰기를 한 번 미루면 될 것 같았다. 하지만 무엇을 미뤄도 되는지부터 Redis를 잃었을 때까지 생각할 게 꽤 많았다.
이번 글에서는 문제를 찾고, 가설을 세우고, 구현해서 다시 측정하기까지의 과정을 공유해 보려고 한다.
이 글의 수치는 운영 환경이 아니라 부하 테스트 환경에서 측정한 값이다.
1. 문제 발견
식사 한 끼는 DB에 어떤 일을 시킬까?
먼저 식사 한 끼를 기록하면 어떤 일이 일어나는지부터 정리했다.
%%{init: {"themeCSS": ".labelBox, .labelText { display: none; }"}}%%
sequenceDiagram
    participant App as 앱
    participant API
    participant DB as MySQL
    participant W as Worker
    App->>API: POST /meals
    API->>DB: 식사, 분석 작업, 보상 우편, 스트릭 저장
    API-->>App: 식사 기록 응답
    loop 1초마다
        W->>DB: 분석 작업 가져오기
    end
    W->>W: Gemini 분석
    W->>DB: 작업 삭제, 식사에 결과 저장
    W->>DB: 푸시 토큰 조회, 푸시 내역 저장
    loop 2초마다
        App->>API: 분석 상태 조회
        API->>DB: 식사 조회
    end
분석 작업은 앞에서 말한 RDB 기반 Task Queue로 전달한다. API가 작업 행을 넣고, Worker가 1초마다 가져가서 분석한 뒤 결과를 식사에 저장한다. 아래에서는 줄여서 DB 큐라고 부른다.
식사 한 끼에 COMMIT이 평균 4.1번 일어난다.
| 누가 | 어떤 트랜잭션 | 식사 한 끼당 COMMIT |
|---|---|---|
| API | 식사 기록(식사, 분석 작업, 보상 우편, 스트릭) | 1번 |
| Worker | 분석 결과 저장(작업 삭제 포함) | 1번 |
| Worker | 푸시 내역 저장 | 1번 |
| Worker | 무효 푸시 토큰 정리 | 1번 |
| Worker | 분석 작업 가져오기 | 약 0.1번 |
여기에 영양 분석 상태 폴링이 더해진다. 분석이 끝날 때까지 앱이 2초마다 물어보니, 식사 한 끼에 조회가 약 4.8번 따라온다.
피크에 가장 먼저 깨지는 곳은 어디일까?
점심과 저녁에 기록이 몰리면 어디가 먼저 버티지 못할까? 직접 부하를 걸어 확인했다.
측정 조건: RDS는 db.m7g.large, 사용자 10만 명을 미리 넣어 두었다.
Gemini는 실제 호출 대신 응답 시간만 흉내 내는 Stub(중앙값 8.5초)을 썼다.
단계마다 120초 워밍업 뒤 300초를 유지했고, 영양 분석 상태 폴링은 끄고 따로 측정했다.
초당 식사 기록 수를 100건에서 300건까지 올렸다.
| 초당 식사 기록 | RDS CPU | 식사 기록 API p95 | 실패율 |
|---|---|---|---|
| 100건 | 34.5% | 134ms | 0% |
| 150건 | 47.5% | 142ms | 0% |
| 200건 | 58.5% | 144ms | 0% |
| 250건 | 69.7% | 164ms | 0% |
| 300건 | 81.5% | 296ms | 0% |
미리 정해 둔 한계 기준은 RDS CPU 70%였다. 250건/s에서 기준에 닿았고, 300건/s에서 넘었다.
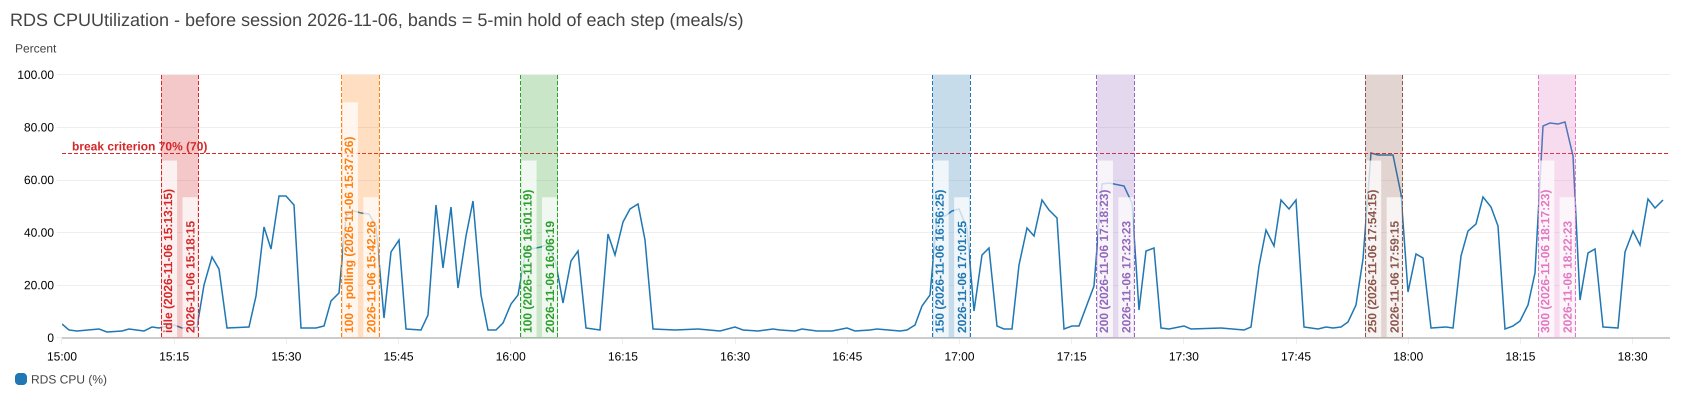
그런데 같은 순간 API와 Worker는 여유가 있었다. 250건/s에서 RDS가 기준에 닿았을 때 API의 커넥션 풀 대기는 0이었다. 300건/s에서도 API와 Worker의 평균 CPU는 30%에 못 미쳤다.
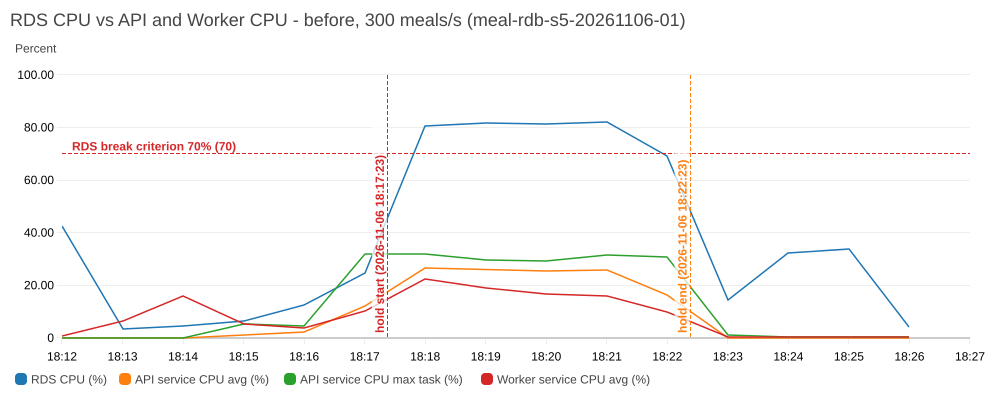
즉, API나 Worker를 늘려서는 풀 수 없고 RDS가 먼저 한계에 닿는 구조였다.
늘어난 부하는 어디에서 왔을까?
RDS가 먼저 깨진다면 그 CPU는 누가 쓰고 있을까?
가장 먼저 의심받을 만한 것은 DB 큐다. Worker 수십 대가 1초마다 큐 테이블을 조회하기 때문이다. 그래서 MySQL이 문장별로 쓴 CPU 시간을 나눠 봤다.
- 식사 기록 경로(기록부터 분석 결과 저장까지): 95~96%
- DB 큐에서 작업을 가져가는 쿼리: 4~5%
DB 큐를 SQS 같은 메시지 큐로 바꿔도 줄어드는 것은 4~5%뿐이다. 큐를 바꾸는 것은 이 문제의 답이 아니었다.
식사 기록 경로 안에서는 API 쪽(기록)이 약 48%, Worker 쪽(결과 저장)이 약 52%였다.
따로 측정한 폴링도 작지 않았다. 같은 100건/s에서 폴링을 켜면 RDS CPU가 34.5%에서 47.3%로 올랐다. 상태를 물어보는 조회만으로 12.8%p를 쓰는 것이다.
그러면 이 중에서 무엇을, 어떻게 줄여야 할까?
2. 문제 정의
결국 해결하려는 문제는 무엇일까?
측정 결과를 놓고 문제를 다시 적어 봤다.
식사 기록이 몰리는 피크에, RDS가 API와 Worker보다 먼저 한계에 닿는다.
피크는 하루 중 점심과 저녁 몇 시간이다. 그 시간에만 RDS를 키웠다 줄일 수도 있지만, RDS는 크기를 바꿀 때마다 다운타임이 생긴다.
그래서 지켜야 할 조건을 이렇게 정했다.
- RDS를 키우지 않고 같은 피크를 더 낮은 CPU로 버텨야 한다.
- 사용자가 남긴 기록과 보상은 어떤 장애에서도 잃으면 안 된다.
- 분석이 끝난 식사가 사용자에게 “분석 중”으로 보이면 안 된다.
- 피크가 예상보다 길어져도 그대로 동작해야 한다.
RDS를 키우거나 코드를 줄이면 안 될까?
Redis를 붙이기 전에 더 단순한 방법부터 따져 봤다.
| 방법 | 기대한 것 | 걸리는 것 |
|---|---|---|
| RDS 스케일업 | 코드를 바꾸지 않아도 된다. | 계속 키워 두면 피크가 아닌 시간에도 비용을 내고, 피크에만 키우면 바꿀 때마다 다운타임이 생긴다. |
| 코드로 줄이기(하루 기록 횟수 조회 줄이기 등) | 식사 한 끼가 DB에 시키는 일이 줄어든다. | 줄여도 피크의 쓰기는 그대로 MySQL에 COMMIT된다. |
| DB 큐를 SQS로 교체 | 큐 조회가 사라진다. | 큐가 쓰는 CPU는 4~5%뿐이다. |
| 읽기 복제본 | 조회를 나눌 수 있다. | 쓰기는 primary에서 빠지지 않는다. |
스케일업은 마지막에 비용을 비교할 대상으로 남겼다.
표를 채우고 보니 필요한 것이 조금 더 분명해졌다. 결국 식사 기록이 들어오는 속도와 RDS에 쓰는 속도를 떼어 놓아야 했다.
3. 가설
그래서 세운 가설은 이렇다.
Worker가 분석 결과를 MySQL에 바로 쓰지 않고 Redis에 먼저 쌓아 두었다가 피크가 지난 뒤에 옮기면, 같은 피크에서 RDS CPU가 줄고 처리 한계가 올라갈 것이다.
측정 전에 문장별 CPU 몫으로 계산해 본 값은 250건/s에서 RDS CPU 약 34%, 처리 한계 약 550건/s였다.
Redis에는 무엇까지 맡겨도 될까?
Write-Behind는 캐시에 먼저 쓰고 DB에는 나중에 쓰는 방식이다. 예전에 토스뱅크 캐시 글을 정리하면서 이 방식의 주의할 부분으로 “반영 전에 데이터가 유실될 수 있다”고 적은 적이 있다. 이번에는 그 문제를 직접 풀어야 했다.
그래서 기준을 하나 정했다.
Redis에는 잃어도 다시 만들 수 있는 것만 둔다. 사용자가 직접 남긴 기록과 보상은 MySQL에만 쓴다.
이 기준으로 데이터를 하나씩 나눠 봤다.
| 데이터 | 다시 만들 수 있나? | 쓰는 곳 |
|---|---|---|
| 식사 기록 | 아니다. 사용자가 남긴 것이다. | MySQL에 바로 |
| 보상 우편과 코인 | 아니다. 재화다. | MySQL에 바로 |
| 스트릭 | 아니다. | MySQL에 바로 |
| 분석 작업 | 다시 분석할 근거라 남아 있어야 한다. | MySQL에 바로 |
| 분석 결과(영양, 이름, 아이콘, 상태) | 그렇다. 다시 분석하면 된다. | Redis 먼저, 나중에 MySQL |
| 푸시 전송 내역 | 기록용이라 잃어도 기능에는 영향이 없다. | Redis 먼저, 나중에 MySQL |
| 폴링용 분석 상태 | 그렇다. MySQL 행에서 다시 만든다. | Redis에 사본 |
| 하루 기록 횟수 | 그렇다. 그날 식사 수를 세면 된다. | Redis 카운터 |
이렇게 나누면 Redis를 잃었을 때의 피해가 달라진다. 데이터를 잃는 것이 아니라, 다시 분석하는 비용을 치르는 것이 된다.
식사 기록까지 Redis에 먼저 쓰면 안 될까?
선택지
- 식사 기록부터 Redis에 먼저 쓴다
- 기록과 분석 거의 전부를 묶어서 반영할 수 있다. 하지만 보상 우편까지 Redis에 두게 되고, Redis를 잃으면 사용자가 “기록됐다”고 응답받은 식사와 보상이 사라진다.
- 식사 기록은 MySQL에 바로 쓰고, 분석 결과만 Redis에 먼저 쓴다
- 사용자가 남긴 기록과 보상은 Redis를 잃어도 남는다.
그래서 식사 기록은 지금처럼 MySQL에 바로 쓰기로 했다.
4. 구현 및 개발
전체 흐름은 이렇게 바뀐다.
%%{init: {"themeCSS": ".labelBox, .labelText { display: none; }"}}%%
sequenceDiagram
    participant App as 앱
    participant API
    participant DB as MySQL
    participant W as Worker
    participant R as Redis
    participant F as Flusher
    App->>API: POST /meals
    API->>DB: 식사, 분석 작업, 보상 우편, 스트릭 저장
    API->>R: 분석 상태 저장(대기 중)
    API-->>App: 식사 기록 응답
    W->>DB: 분석 작업 가져오기
    W->>W: Gemini 분석
    W->>R: 분석 결과 저장
    W->>DB: 작업 삭제(1초 묶음)
    W->>R: 확정 표시, 반영 대기열에 추가
    loop 2초마다
        App->>API: 분석 상태 조회
        API->>R: 상태 조회
    end
    Note over F,DB: 피크가 지나면
    F->>R: 반영 대기열에서 꺼내기
    F->>DB: 묶어서 반영
식사 기록은 그대로 MySQL에 쓴다. 달라진 것은 Worker가 결과를 Redis에 쓰고, 영양 분석 상태 폴링도 Redis에서 답하고, Flusher라는 새 역할이 나중에 MySQL로 옮긴다는 점이다.
분석 결과는 Redis에 어떻게 쌓일까?
분석 결과는 식사마다 Hash 하나에 담는다. 그런데 Hash만 있으면 Flusher가 “아직 MySQL에 옮기지 않은 것”을 찾으려고 전부 훑어야 한다.
그래서 할 일 목록을 따로 뒀다. Worker가 “이 식사를 옮겨 달라”는 항목을 대기열 끝에 붙이고, Flusher는 앞에서부터 꺼내 옮긴다. 이 반영 대기열을 무엇으로 만들지 세 가지를 비교했다.
| 후보 | Flusher가 도중에 죽으면? | 주의할 부분 |
|---|---|---|
| List | 처리 중 목록을 직접 되돌려야 한다. | 복구 로직을 직접 짜야 한다. |
| Sorted Set | 지우기 전이라 남아서 다시 처리된다. | 읽은 뒤 새 결과가 들어오면, 완료 처리가 새 표시까지 지울 수 있다. |
| Stream + consumer group | 가져갔지만 끝내지 못한 항목이 남아 다시 처리된다. | 처리 대기 목록을 다루는 코드가 필요하다. |
Stream을 골랐다. Stream은 가져갔지만 아직 끝내지 않은 항목을 Redis가 기억해 준다. Flusher가 MySQL에 커밋한 뒤에만 완료 표시를 하면, 도중에 죽어도 항목을 잃지 않는다.
항목에는 결과를 통째로 넣지 않고 어떤 식사인지만 넣었다. Flusher는 반영하는 순간에 Hash의 최신 값을 읽는다. 그래서 같은 식사의 항목이 여러 번 들어가거나 순서가 섞여도 항상 최신 결과가 쓰인다.
Worker가 결과를 남기는 순서는 이렇다.
1
2
3
4
5
1. Redis에 결과 저장 (아직 미확정)
2. S3에 결과 사본 저장
3. MySQL에서 분석 작업 삭제 (1초 묶음)
4. 삭제에 성공한 결과만 확정 표시 + 반영 대기열에 추가
5. 확정된 결과만 푸시 발송
여기서는 순서가 곧 정확성이었다. 3번의 작업 삭제는 “이 결과가 내 것이 맞다”를 확인하는 단계다. 다른 Worker가 이미 가져간 작업이면 삭제가 0행으로 끝나고, 그 결과는 확정하지 않는다.
4번의 확정 표시와 대기열 추가는 한 번에 일어나야 한다. Flusher는 확정된 결과가 없으면 항목만 지우기 때문에, 항목이 확정보다 먼저 들어가면 결과를 반영하지 못하고 잃는다. 그래서 두 동작을 Lua 스크립트 하나로 묶었다.
작업 삭제를 1초씩 묶은 것도 이유가 있다. 삭제를 반영 때까지 미루면, 60초 뒤 다른 Worker가 같은 작업을 다시 가져가 분석한다. 그래서 삭제만은 미루지 않고 짧게 묶어서 바로 실행한다.
쌓인 결과는 누가 옮길까?
Redis에 쌓인 결과를 MySQL로 옮기는 역할이 필요했다.
선택지
- Worker 안에서 같이 한다
- 서비스를 새로 띄우지 않아도 된다. 하지만 Worker는 부하에 따라 수십 대까지 바뀌어서, “지금 RDS에 얼마나 써도 되는지”를 서로 나눠야 한다.
- 별도 서비스 하나로 띄운다
- 얼마나 쓸지를 한 곳에서 정하면 된다. 대신 운영할 서비스가 하나 늘어난다.
그래서 Flusher를 따로 뒀다. Worker와 같은 이미지를 반영 전용 설정으로 띄운 별도 서비스이고, 하나만 띄운다.
언제 옮길까?
피크에는 멈추고, 한가해지면 옮겨야 한다. 문제는 지금이 피크인지를 무엇으로 아느냐였다.
선택지
- 피크 시간대를 정해 두고 그 시간에는 멈춘다
- 가장 단순하다. 하지만 기록이 몰리는 시각은 날마다 12시, 14시, 17시, 18시로 흔들렸고, 피크가 갑자기 3시간 동안 이어지면 답이 없다.
- RDS CPU를 직접 본다
- DB가 바쁜지를 그대로 알 수 있다. 하지만 CloudWatch 지표는 1분 단위라 늦게 들어온다.
- 초당 식사 기록 수를 본다
- 앞의 측정에서 RDS CPU는 식사 기록 수에 비례했다. 대신 DB를 직접 보지는 않는다.
그래서 초당 식사 기록 수를 기준으로 삼았다. 유입량은 DB 부하의 결과가 아니라 원인을 직접 보는 신호인 셈이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
fun calculateFlushCapacity(
    mealInflowPerSecond: Double,
    intervalSeconds: Double,
    properties: FlusherProperties,
): Double {
    val estimatedCpu =
        properties.baselineCpu + mealInflowPerSecond * properties.cpuPerMeal + properties.nonMealCpuMargin
    val remainingCpu = properties.targetCpu - estimatedCpu
    if (remainingCpu <= 0) {
        return 0.0
    }
    return remainingCpu / properties.cpuPerFlush * intervalSeconds
}
유입량으로 지금의 RDS CPU를 어림하고, 기준까지 남은 몫을 반영 1건의 비용으로 나눈다. 남은 몫이 없으면 0이라 반영이 멈춘다. 유입이 줄면 남은 몫이 조금씩 커지므로, 피크 뒤에 쌓인 결과가 한꺼번에 RDS로 쏟아지지 않는다.
이 방식은 DB를 직접 보지 않는다. 식사 기록이 아닌 이유로 DB가 바쁘면 알 수 없다. 그래서 기준까지 꽉 채워 쓰지 않고 여유를 남겨 뒀다.
옮기기 전에 사용자가 식사를 조회하면?
결과가 Redis에만 있는 동안 MySQL의 식사는 아직 “분석 중”이다. 조회가 MySQL만 보면 분석이 끝난 식사가 분석 중으로 보이고, 하루 섭취 합계에서도 빠진다.
그래서 식사를 읽을 때는 MySQL에서 읽은 식사 위에 Redis의 결과를 덮어쓴다. Redis에는 아직 분석이 끝나지 않은 식사만 묻는다. 한 달 치 캘린더를 읽어도 Redis는 진행 중인 몇 끼만 본다.
읽는 순서는 MySQL이 먼저, Redis가 나중이다. 반대로 읽으면 그 사이에 반영이 끝나 Redis의 결과가 지워졌을 때, MySQL의 옛 “분석 중”을 보게 된다.
영양 분석 상태 폴링은 Redis만 본다. 그러려고 결과뿐 아니라 “대기 중”, “분석 중” 상태도 Redis에 함께 써 둔다. 폴링의 대부분은 결과가 나오기 전에 오기 때문에, 결과만 Redis에 두면 폴링 부하는 거의 그대로 남는다.
Redis가 통째로 사라지면?
Worker는 Redis에 결과를 쓴 뒤에 MySQL의 분석 작업을 지운다. 문제는 작업을 지운 뒤에 Redis가 결과를 잃는 경우다. 작업도 결과도 없으니 처음부터 다시 분석해야 한다. 분석 비용이 다시 들고, 알림이 한 번 더 가고, 사용자가 이미 본 결과가 바뀔 수도 있다.
게다가 결과는 피크에 가장 많이 쌓인다. 유실이 가장 바쁠 때 가장 크게 일어나는 것이다.
ElastiCache의 Valkey는 AOF를 지원하지 않는다. 두 노드를 모두 잃으면 쌓인 결과도 함께 사라진다.
선택지
- EC2에 직접 올려 Sentinel과 AOF를 구성한다
- 결과가 디스크에 남는다. 하지만 EC2 3대와 장애 조치를 혼자 운영해야 하고, 두 노드의 디스크를 모두 잃으면 다시 분석해야 한다.
- 결과를 S3에 한 번 더 쓴다
- Redis를 통째로 잃어도 S3에서 되살릴 수 있다. 대신 식사마다 S3 쓰기가 한 번 더 생기고, 되살리는 배치가 필요하다.
그래서 결과를 S3에 한 번 더 쓰고, Redis와 S3에 둘 다 성공한 결과만 작업을 지우기로 했다. 작업이 지워졌다면 그 결과는 반드시 S3에 있다.
복구는 1분마다 도는 대사 배치가 맡는다. “분석 중인데 작업 행도 없고, Redis에 확정된 결과도 없는 식사”를 찾아 S3 사본에서 되살린다.
늦게 끝난 Worker가 결과를 덮어쓰면?
여기까지가 큰 흐름이다. 남은 것은 같은 식사에 결과가 두 번 쓰이는 경우다.
Worker가 작업을 가져가서 60초 안에 끝내지 못하면, 다른 Worker가 그 작업을 다시 가져간다. 그러면 이런 일이 생길 수 있다.
1
2
3
4
12:00:00  Worker A가 작업을 가져간다
12:01:00  A가 60초를 넘겨, Worker B가 같은 작업을 다시 가져간다
12:01:09  B가 분석을 끝내고 결과를 Redis에 쓴다
12:01:12  뒤늦게 끝난 A가 자기 결과를 Redis에 쓴다
마지막 줄에서 옛 결과가 새 결과를 덮는다. MySQL에 바로 쓸 때는 없던 문제다. 그때는 A의 작업 삭제가 0행으로 끝나서 결과도 쓰지 않았다. 이제는 작업을 지우기 전에 Redis에 먼저 쓴다.
그래서 결과마다 버전을 붙였다. 작업을 몇 번째로 가져갔는지가 버전이다. A는 1번째, B는 2번째이므로 A의 결과는 B의 결과를 덮지 못한다. 비교와 쓰기 사이에 다른 명령이 끼어들지 못하도록 Lua 스크립트 하나로 처리한다.
다만 횟수만으로는 부족했다. 사용자가 다시 분석을 요청하면 작업이 새로 만들어지고, 횟수도 처음부터 다시 센다. 그래서 (작업 id, 가져간 횟수) 쌍을 버전으로 썼다. 작업 id는 새 작업일수록 크다.
옮기는 도중에 사용자가 재분석을 요청하면?
Redis 안에서의 덮어쓰기는 버전으로 막았다. 그런데 MySQL에 쓰는 순간에도 비슷한 일이 생긴다.
1
2
3
1. Flusher가 Redis에서 식사의 결과를 읽는다
2. 사용자가 그 식사를 다시 분석해 달라고 요청한다
3. Flusher가 1번에서 읽어 둔 옛 결과를 MySQL에 쓴다
3번에서 다시 분석 중인 식사가 옛 결과로 “분석 완료”가 된다. Flusher는 이미 결과를 읽은 뒤라, Redis의 버전 비교로는 막을 수 없다.
그래서 식사 행에 “지금 분석 작업 id”를 두고, 반영하는 UPDATE가 같은 행에서 직접 확인하도록 했다.
1
2
3
4
5
6
7
8
9
UPDATE meals
SET status = 'COMPLETED',
    calory = :calory,
    carbs = :carbs,
    protein = :protein,
    fat = :fat
    -- 나머지 컬럼 생략
WHERE id = :mealId
  AND (current_analysis_job_id IS NULL OR current_analysis_job_id <= :jobId)
재분석이 먼저 커밋되면 옛 결과의 반영은 0행으로 끝난다. 판단이 행 하나 안에서 끝나기 때문에, 누가 먼저 커밋하든 결과가 분명하다.
5. 검증
같은 조건에서 얼마나 달라졌을까?
구현을 마치고 처음과 같은 조건으로 다시 측정했다. 같은 RDS, 같은 사용자 데이터, 같은 API와 Worker 수, 같은 단계다.
| 초당 식사 기록 | 적용 전 RDS CPU | 적용 후 RDS CPU | 감소 |
|---|---|---|---|
| 100건 | 34.5% | 25.4% | 26% |
| 150건 | 47.5% | 36.8% | 23% |
| 200건 | 58.5% | 45.1% | 23% |
| 250건 | 69.7% | 52.5% | 25% |
| 300건 | 81.5% | 58.8% | 28% |
| 350건 | 측정 안 함 | 69.7% | |
| 400건 | 측정 안 함 | 77.2% | |
| 100건(폴링 켬) | 47.3% | 27.3% | 42% |
기준 70%에 닿는 지점이 약 250건/s에서 약 350건/s로 올라갔다. 1.4배다.
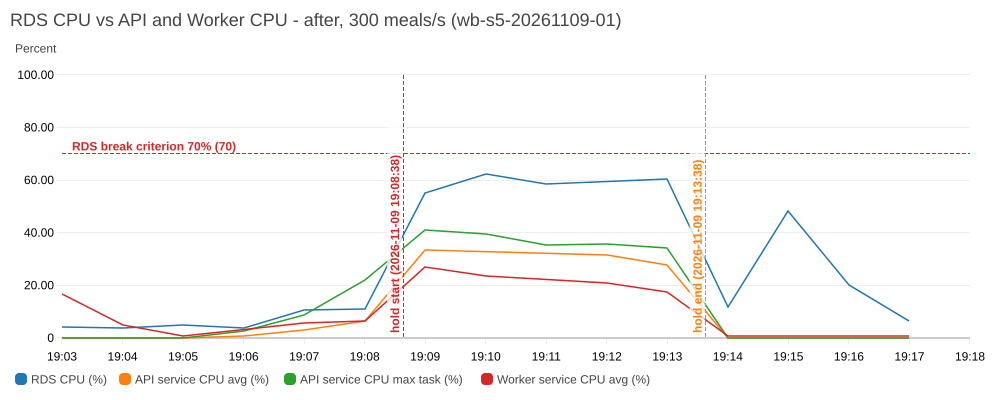
같은 300건/s에서 RDS CPU가 81.5%에서 58.8%로 내려왔다. 식사 기록 API의 p95도 296ms에서 196ms로 줄었다.
효과가 가장 컸던 것은 폴링을 켠 조건이다. 폴링이 Redis로 옮겨 가면서 47.3%가 27.3%로 줄었다.
반영이 RDS에 주는 부담도 확인했다. 피크가 끝난 뒤 반영하는 동안 RDS CPU는 4% 안팎으로, 아무 요청이 없을 때(4.4%)와 구분되지 않았다.
예상과는 맞았을까?
맞지 않았다.
| 측정 전 계산 | 실측 | |
|---|---|---|
| 250건/s에서 RDS CPU | 약 34% | 52.5% |
| 처리 한계 | 약 550건/s | 약 350건/s |
피크에 RDS에 남는 몫을 46%로 계산했는데, 실제로는 64~65%가 남았다.
계산은 “RDS CPU가 문장별 CPU 시간에 비례한다”는 가정 위에 있었다. 실제로 문장이 쓴 CPU 시간은 35~36% 줄었다. 그런데 RDS CPU는 그만큼 줄지 않았다. I/O나 백그라운드 작업의 몫이 남기 때문으로 보이지만, 여기까지는 확인하지 못했다.
처리 한계가 2.2배가 될 것이라고 계산했지만, 실제로는 1.4배였다. 방향은 맞았고 크기는 틀렸다.
도중에 죽이면 결과가 사라질까?
Write-Behind에서 가장 걱정한 것은 유실이다. 150건/s로 부하를 거는 도중에 구성 요소를 하나씩 죽여 봤다.
| 장애 | 결과 |
|---|---|
Flusher 강제 종료(kill -9) | 식사 29,399건이 모두 정확히 반영됐다. 중복도 없다. |
Worker 강제 종료(kill -9) | 식사 29,399건이 모두 정확히 반영됐다. 중복도 없다. |
| 버퍼 Redis failover | 분석 결과 유실은 0건. 푸시 전송 내역이 76건 부족했다. |
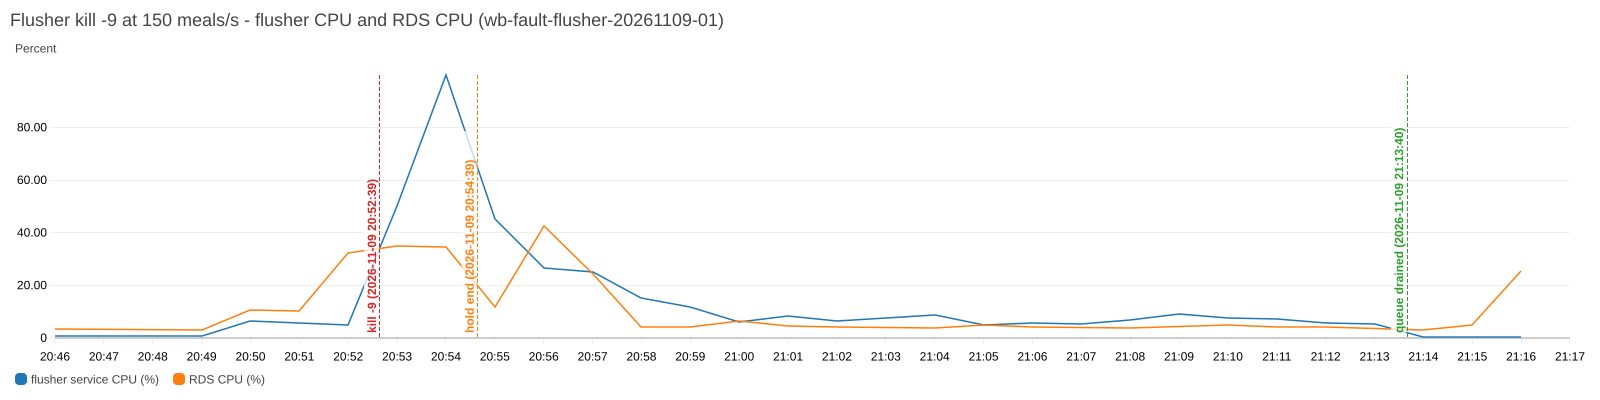
Flusher는 다시 뜨면서, 이전 Flusher가 가져갔다가 끝내지 못한 항목을 넘겨받아 이어서 반영했다. Stream을 고른 이유가 여기서 확인됐다.
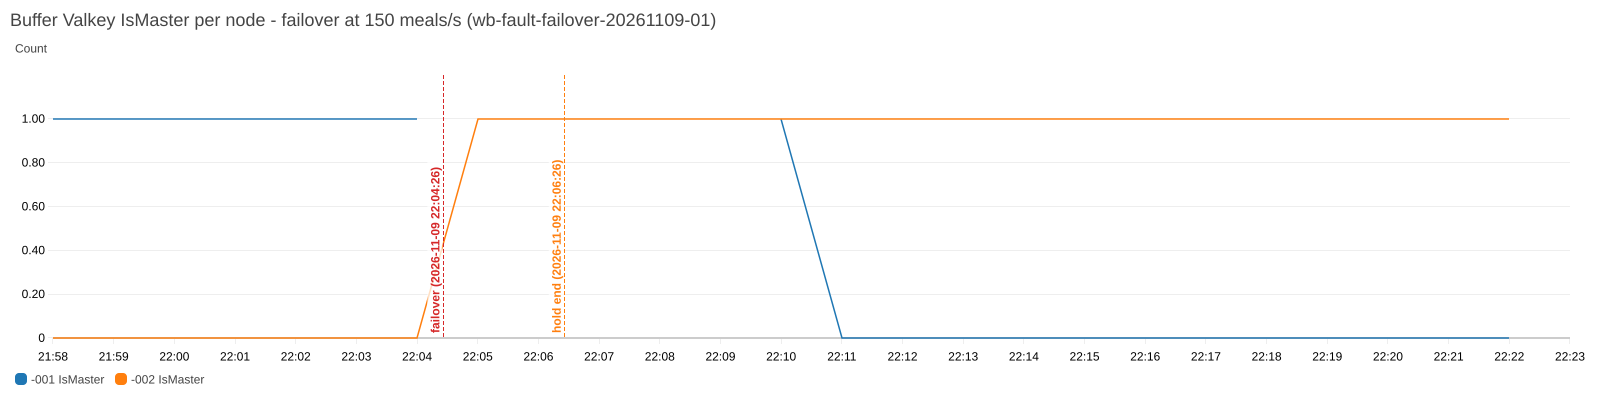
failover에서는 푸시 전송 내역 76건(0.26%)이 사라졌다. 복제가 비동기라 그 순간의 항목을 잃은 것으로 보인다. 분석 결과에는 S3 사본이라는 복구 경로가 있지만, 전송 내역에는 없다.
전송 내역은 처음부터 “잃어도 기능에는 영향이 없는 것”으로 분류했다.
6. 결론
처음에는 피크에 RDS가 가장 먼저 깨진다는 사실에서 시작했다.
문장별로 나눠 보니 원인은 DB 큐가 아니라 식사 기록 경로였다. 그중에서 잃어도 다시 만들 수 있는 것만 골라 Redis로 미뤘다. 그 결과 RDS를 키우지 않고 처리 한계가 약 250건/s에서 약 350건/s로 올라갔다.
바뀐 구조를 한 장으로 그리면 이렇다.
대신 치른 값도 있다. 버퍼 전용 노드와 Flusher가 생겼고, 식사를 읽는 곳에는 덮어쓰기가 필요해졌고, 대사 배치를 운영해야 한다.
비용도 따져 봤다. RDS를 한 단계 키우면 월 약 685달러, 지금 RDS에 버퍼 노드와 Flusher를 더하면 월 약 587달러다. 350건/s를 맞추는 것이 목표라면 14% 정도 싸다. 하지만 RDS를 한 단계 키우면 계산상 500건/s 가까이 버틴다. 처리량 대비 비용만 보면 스케일업이 더 낫다.
이 구조로 얻은 것은 비용보다, RDS를 키우지 않고 피크의 쓰기를 RDS에서 떼어 냈다는 점이다.
한계를 올리고 나니 다음 병목도 보였다.
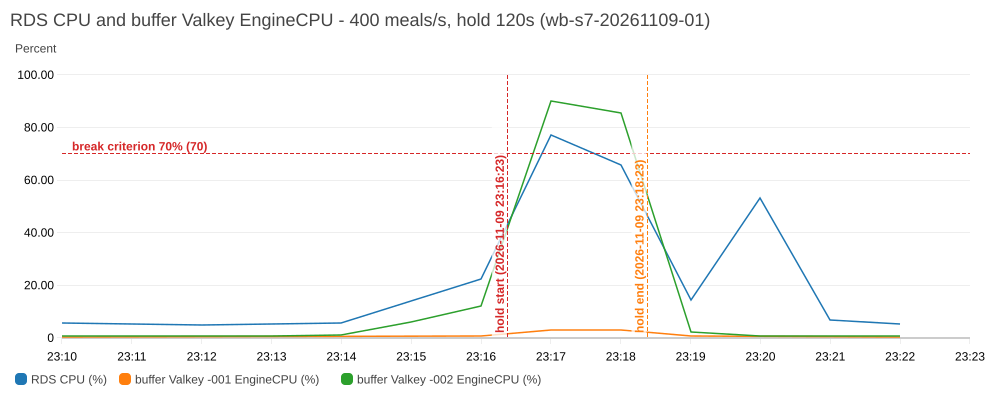
- RDS CPU: 여전히 가장 먼저 닿는다. 남은 것은 API의 쓰기다.
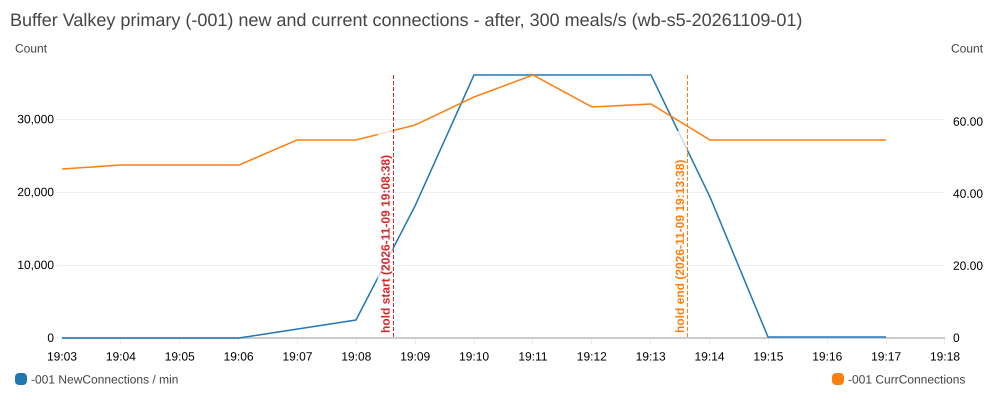
- 버퍼 Redis: 400건/s에서 CPU가 90%까지 올랐다. 커넥션 풀 설정이 빠져 있어 식사 한 끼마다 TLS 연결을 두 번 가까이 새로 맺고 있었는데, 이것이 유력한 원인이다.
- 반영 속도: 대기열이 얼마나 쌓였든 초당 49항목으로 고정돼 있었다. 300건/s 피크 5분 동안 쌓인 18만 항목을 비우는 데 계산상 1시간이 걸린다.
RDS의 부담을 Redis로 옮겼더니, 이번에는 Redis 쪽에서 내가 놓친 설정이 병목이 된 것이다.
이번 글에서 가장 기억에 남는 것은 측정 전에 계산한 숫자와 실제 숫자가 달랐다는 점이었다. 계산으로는 2.2배였지만 실제로는 1.4배였다. 재 보지 않았다면 틀린 숫자를 그대로 믿었을 것이다.
이후에 이 구조를 어떻게 발전시켜 나갈지는 후속편으로 남겨 보려고 한다.